02 · AI Engineering / Évaluation du retrieval
SecureBank-AI — Sécuriser une plateforme RAG avec RBAC et JWT
Une plateforme RAG hybride qui associe authentification JWT, gestion RBAC et contrôle d’accès RBAC à la comparaison reproductible de quatre stratégies de recherche documentaire : BM25, recherche vectorielle, fusion RRF et reranking.
- Documents synthétiques
- 30
- Questions d’évaluation
- 40
- Chunks indexés
- 172
Question d’ingénierie
Comment concevoir et évaluer un système RAG pertinent, tout en l’intégrant dans une application fiable avec des accès maîtrisés ?
Sécurité applicative
Sécurité applicative et contrôle des accès
SecureBank-AI ne se limite pas à comparer des moteurs de recherche documentaire. Le projet intègre aussi une couche de sécurité applicative pour gérer l’identité des utilisateurs, contrôler l’accès aux fonctionnalités et protéger les informations d’authentification.
Cette dimension complète le travail d’AI Engineering : un système RAG doit aussi s’intégrer dans une application structurée, avec des API RAG protégées, des sessions maîtrisées et une gestion explicite des autorisations.
- 01
Authentification & autorisation
JWT · RBAC · API RAG protégées
La validation JWT contrôle la signature, l’expiration, l’émetteur et l’audience avant d’identifier l’utilisateur. Des dépendances FastAPI explicites autorisent ensuite l’accès aux ressources RAG selon le rôle : l’authentification établit l’identité, l’autorisation détermine l’action permise. Le compte de démonstration configuré par environnement utilise le rôle analyst.
- 02
Identifiants & sessions
bcrypt · Cookie HttpOnly · CSRF
Les mots de passe sont hachés avec bcrypt. Les jetons de session et CSRF sont générés séparément. Les jetons de session sont stockés sous forme de hash dans SQLite, expirent et sont invalidés à la déconnexion. Le cookie de session est HttpOnly ; SESSION_COOKIE_SECURE et SESSION_COOKIE_SAMESITE configurent sa politique de transport. Le frontend envoie les cookies avec credentials: "include" et transmet le jeton CSRF pour les requêtes mutables.
- 03
Protection des API & configuration
Origines de confiance · Variables d’environnement · Secrets
L’origine des connexions est contrôlée par une liste autorisée et les requêtes mutables authentifiées par cookie exigent une validation CSRF. Les échecs de connexion sont limités. AUTH_TRUSTED_ORIGINS, JWT_SECRET_KEY et DEMO_USER_PASSWORD maintiennent la configuration sensible hors de l’interface publique. Aucune valeur secrète n’est exposée ici.
- 04
Gestion des utilisateurs & persistance
SQLite · User repository · Association des rôles
SQLiteUserRepository persiste les comptes, les hash de mots de passe, leur état d’activation et leur rôle. Au démarrage, un compte de démonstration optionnel est initialisé de façon idempotente depuis la configuration d’environnement avec le rôle analyst, sans remplacer un compte existant.
- Requête utilisateurIdentité et identifiants
- AuthentificationValidation JWT ou session par cookie
- AutorisationRBAC et dépendance de rôle
- Ressources protégéesAPI RAG et PII
PersistanceSQLiteUtilisateurs · Rôles · Sessions hachées
Configuration d’exécutionEnvironnementOrigines autorisées · Politique des cookies · Secrets
AI Engineering
RAG hybride, stratégies de retrieval, benchmarking et évaluation de la pertinence.
Software Engineering
FastAPI, React, TypeScript, API REST, persistance, tests et déploiement.
Application Security
Authentification JWT, RBAC, hachage des mots de passe, sessions et contrôle des accès.
SecureBank-AI associe l’expérimentation RAG à une architecture full-stack intégrant des mécanismes d’authentification, d’autorisation et de gestion des utilisateurs.
La réponse se joue en amont
Un modèle de langage ne peut ancrer sa réponse que dans le contexte reçu. Si le retrieval manque le passage pertinent, surclasse une preuve faible ou retourne des sources redondantes, la génération commence avec un déficit d’information.
SecureBank-AI traite le retrieval comme un sous-système d’ingénierie observable. Quatre moteurs alternatifs suivent un même protocole expérimental afin de comparer les comportements lexical, sémantique, hybride et reranké, plutôt que de les supposer.
Architecture de retrieval
Les documents sont découpés en chunks, indexés pour la recherche lexicale et vectorielle, puis interrogés via l’une des quatre configurations d’évaluation. RRF fusionne les classements ; FlashRank est une étape optionnelle réservée à la quatrième configuration.
Question
Chunks indexés
Configurations alternatives
Contexte retrouvéIntégration LLM en aval
- 01
BM25
Une baseline lexicale qui score les passages selon la pertinence des termes.
- 02
Qdrant
Recherche vectorielle sémantique avec les embeddings paraphrase-multilingual-MiniLM-L12-v2.
- 03
RRF
Reciprocal Rank Fusion combine les classements indépendants de BM25 et Qdrant.
- 04
RRF + FlashRank
FlashRank reclasse les candidats hybrides dans une configuration expérimentale distincte.
Méthodologie d’évaluation
RAG v2 : un corpus, quatre configurations
Le benchmark utilise 30 documents synthétiques, 40 questions et 172 chunks indexés. Qwen juge 260 paires question-document pour construire des annotations expérimentales de pertinence ; 38 questions sur 40 ont au moins un document jugé pertinent.
Le même benchmark expose la qualité du classement, le succès du retrieval, la couverture des sources et des preuves, la diversité, la latence et les erreurs des quatre moteurs. Les résultats sont des observations descriptives pour ce corpus et cette configuration.
Les jugements de pertinence générés par un LLM sont des annotations expérimentales, pas une validation humaine systématique.
- RAG v2
- 30 documents
- 40 questions
- 172 chunks
- 4 stratégies
- 260 paires jugées
- 38/40 avec preuve pertinente
Résultats
RRF est la configuration globale la plus solide sur ce benchmark
RRF domine les métriques observées de classement et de retrieval tout en maintenant une latence moyenne proche de 15 ms. Il s’agit d’un résultat de benchmark, pas d’un score global artificiel ni d’une garantie en production.
Résultat principalRRF
Success@3 89,5%
- Precision@1
- 65,8%
- Recall@3
- 69,8%
- MAP@3
- 61,1%
- MRR@3
- 76,3%
- nDCG@3
- 64,3%
- Latence moyenne
- 15,0 ms
| Métrique | BM25 | Qdrant | RRF | RRF + FlashRank |
|---|---|---|---|---|
| Precision@1 | 52,6% | 63,2% | 65,8% — Meilleure valeur observée | 52,6% |
| Recall@3 | 58,9% | 63,0% | 69,8% — Meilleure valeur observée | 60,6% |
| MAP@3 | 50,5% | 56,4% | 61,1% — Meilleure valeur observée | 50,9% |
| MRR@3 | 64,9% | 72,4% | 76,3% — Meilleure valeur observée | 66,7% |
| nDCG@3 | 56,4% | 56,1% | 64,3% — Meilleure valeur observée | 55,0% |
| Success@3 | 78,9% | 81,6% | 89,5% — Meilleure valeur observée | 84,2% |
| Source Hit@3 | 89,5% — Meilleure valeur observée | 86,8% | 89,5% — Meilleure valeur observée | 89,5% — Meilleure valeur observée |
| Evidence Hit@3 | 78,9% | 81,6% | 89,5% — Meilleure valeur observée | 84,2% |
| Latence moyenne | 0,4 ms — Meilleure valeur observée | 14,0 ms | 15,0 ms | 421,6 ms |
| Latence P95 | 0,7 ms — Meilleure valeur observée | 18,3 ms | 17,2 ms | 541,9 ms |
Voir les 22 indicateurs
| Métrique | BM25 | Qdrant | RRF | RRF + FlashRank |
|---|---|---|---|---|
| Precision@1 | 52,6% | 63,2% | 65,8% — Meilleure valeur observée | 52,6% |
| Precision@3 | 42,1% | 46,5% | 50,0% — Meilleure valeur observée | 42,1% |
| Recall@1 | 27,3% | 30,8% | 31,2% — Meilleure valeur observée | 26,8% |
| Recall@3 | 58,9% | 63,0% | 69,8% — Meilleure valeur observée | 60,6% |
| F1@1 | 34,2% | 39,9% | 40,7% — Meilleure valeur observée | 33,6% |
| F1@3 | 46,9% | 51,3% | 55,4% — Meilleure valeur observée | 46,8% |
| MAP@3 | 50,5% | 56,4% | 61,1% — Meilleure valeur observée | 50,9% |
| Success@1 | 52,6% | 63,2% | 65,8% — Meilleure valeur observée | 52,6% |
| Success@3 | 78,9% | 81,6% | 89,5% — Meilleure valeur observée | 84,2% |
| Source Hit@1 | 71,1% | 71,1% | 78,9% — Meilleure valeur observée | 63,2% |
| Source Hit@3 | 89,5% — Meilleure valeur observée | 86,8% | 89,5% — Meilleure valeur observée | 89,5% — Meilleure valeur observée |
| Evidence Hit@1 | 52,6% | 63,2% | 65,8% — Meilleure valeur observée | 52,6% |
| Evidence Hit@3 | 78,9% | 81,6% | 89,5% — Meilleure valeur observée | 84,2% |
| MRR@3 | 64,9% | 72,4% | 76,3% — Meilleure valeur observée | 66,7% |
| nDCG@3 | 56,4% | 56,1% | 64,3% — Meilleure valeur observée | 55,0% |
| Latence moyenne | 0,4 ms — Meilleure valeur observée | 14,0 ms | 15,0 ms | 421,6 ms |
| Latence P50 | 0,4 ms — Meilleure valeur observée | 13,0 ms | 15,6 ms | 422,7 ms |
| Latence P95 | 0,7 ms — Meilleure valeur observée | 18,3 ms | 17,2 ms | 541,9 ms |
| Taux d’erreur | 0% — Meilleure valeur observée | 0% — Meilleure valeur observée | 0% — Meilleure valeur observée | 0% — Meilleure valeur observée |
| Chunks retournés en moyenne | 3 | 3 | 3 | 3 |
| Documents distincts@3 | 2,37 | 2,29 | 2,21 | 2,45 — Meilleure valeur observée |
| Diversité des sources@3 | 78,9% | 76,3% | 73,7% | 81,6% — Meilleure valeur observée |
Arbitrages d’ingénierie
Le reranking n’est pas automatiquement bénéfique
Face à RRF, FlashRank fait reculer MAP@3 de 61,1 % à 50,9 %, nDCG@3 de 64,3 % à 55,0 % et Success@3 de 89,5 % à 84,2 %. La latence moyenne passe de 15,0 ms à 421,6 ms — environ 28×. Cet arbitrage observé est propre au corpus, au benchmark et à la configuration ciblés.
BM25 reste une baseline utile
BM25 atteint 89,5 % de Source Hit@3 avec une latence moyenne de 0,4 ms. Le retrieval lexical reste une option crédible à faible latence ; le vectoriel n’est pas intrinsèquement supérieur.
L’hybride RRF justifie sa place
MAP@3 progresse de 50,5 % pour BM25 et 56,4 % pour Qdrant à 61,1 % pour RRF. L’observation invite à évaluer les approches lexicale, sémantique et hybride plutôt qu’à choisir un moteur sur des suppositions.
Implémentation full-stack
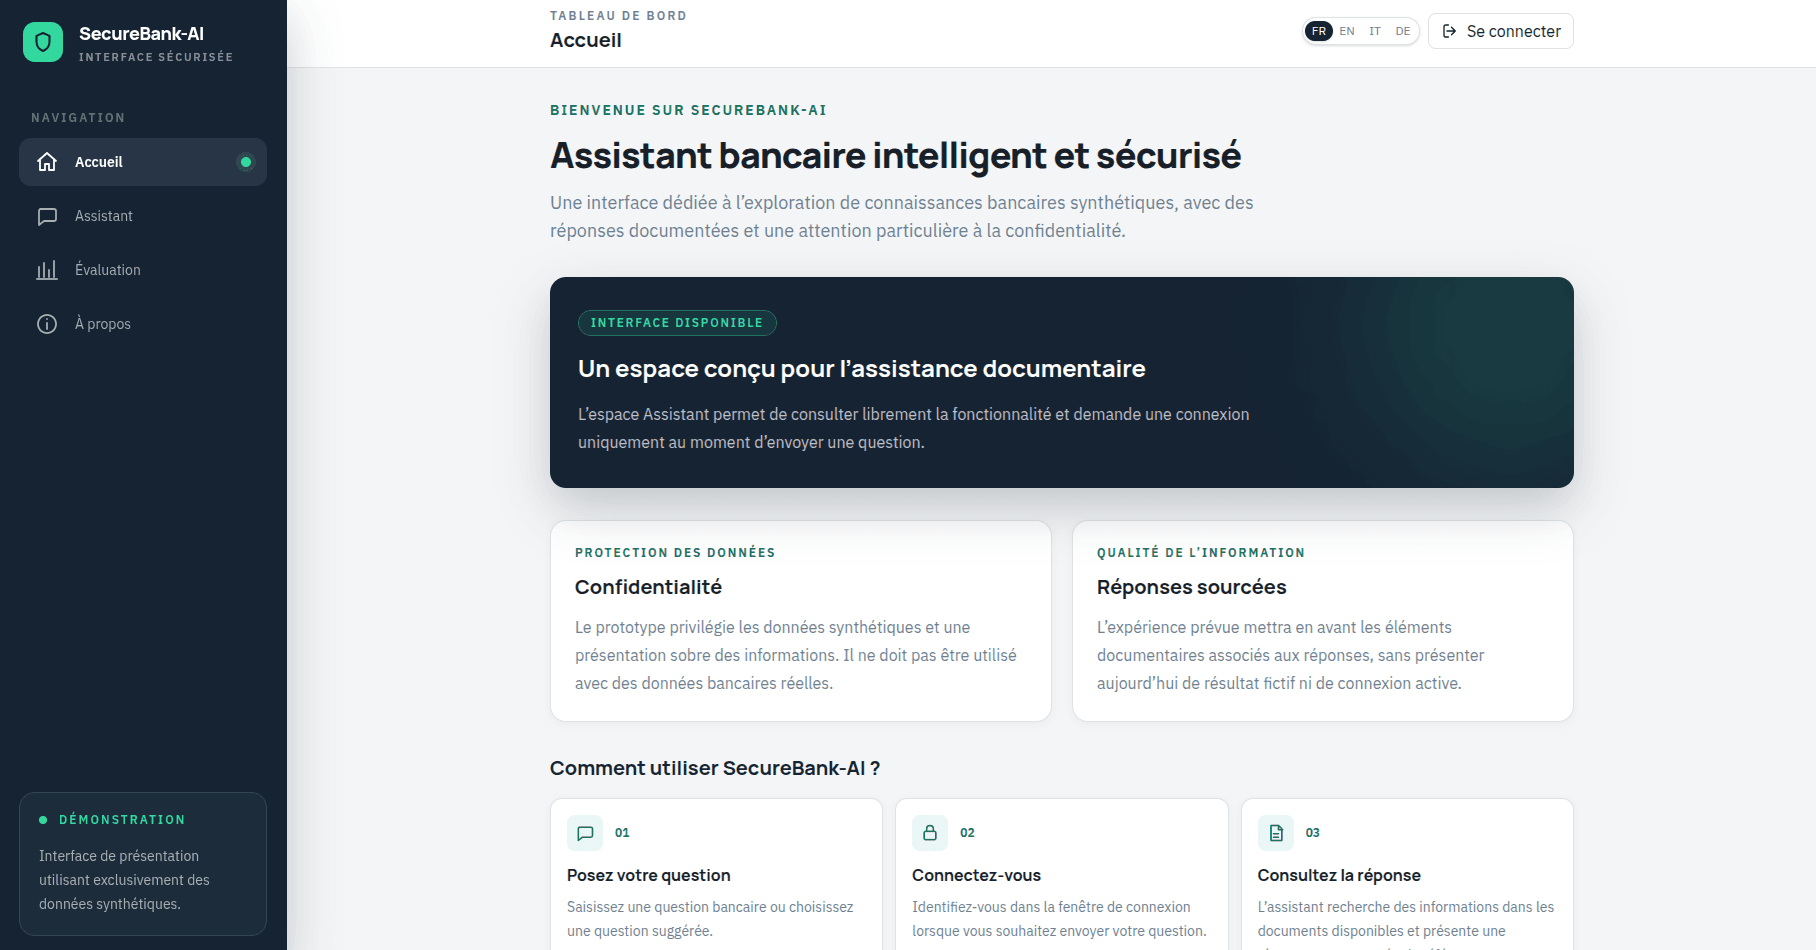
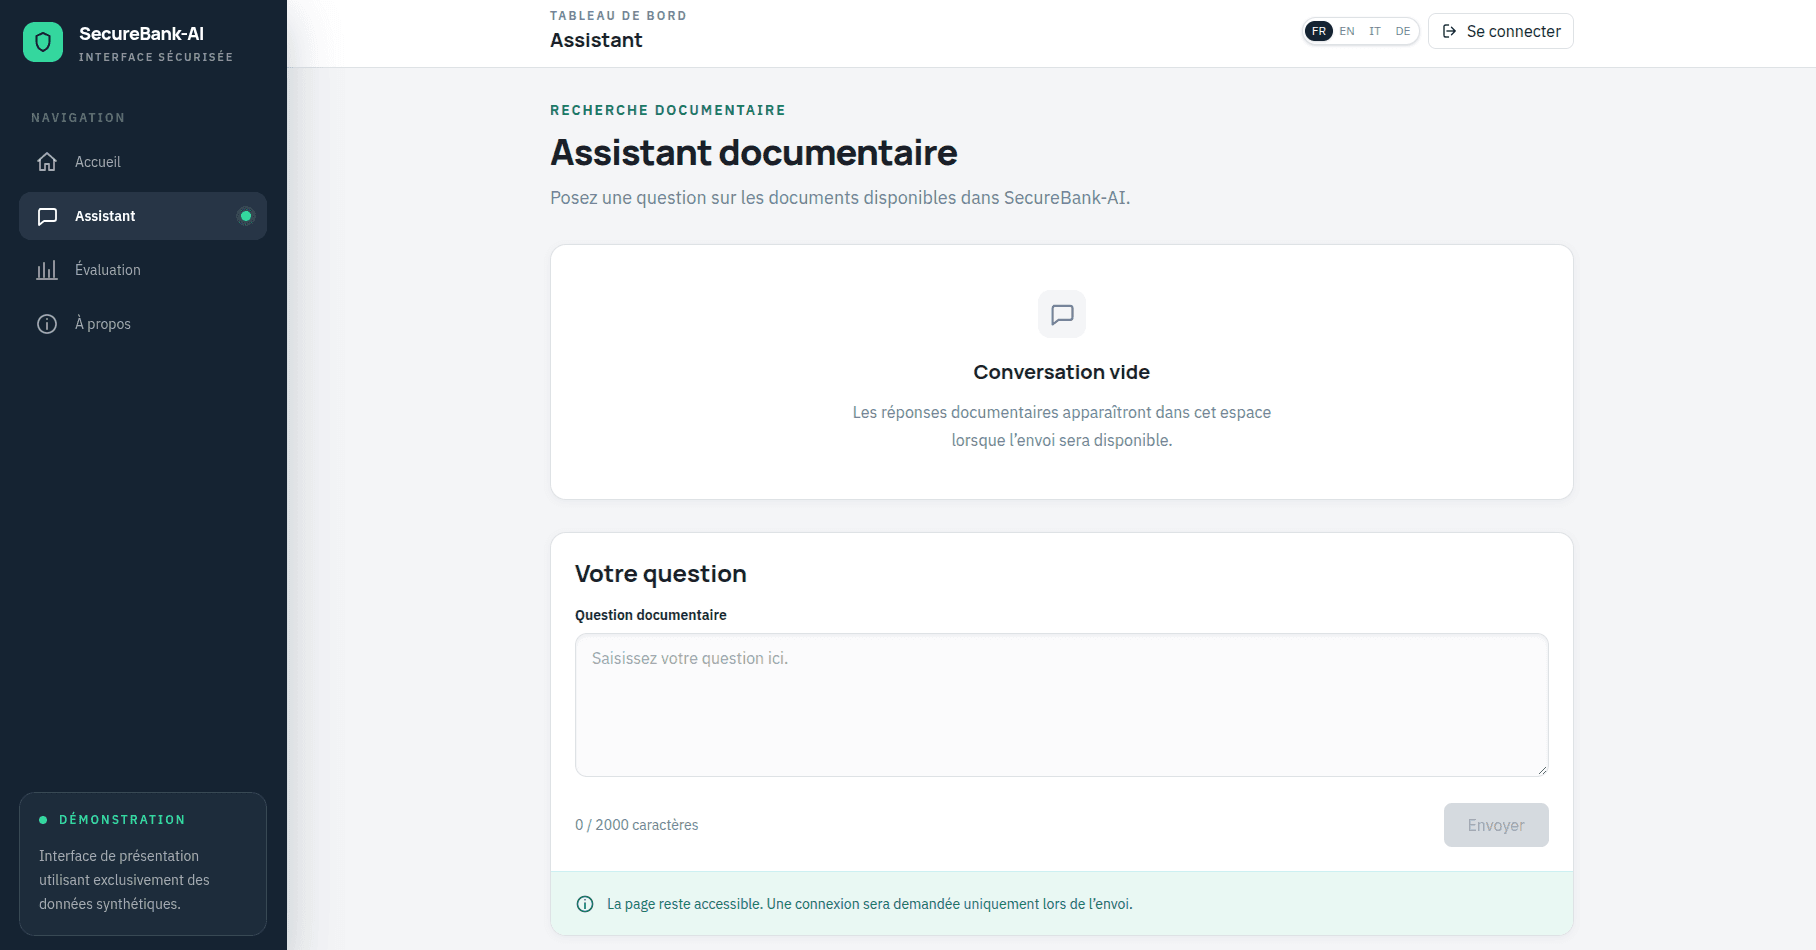
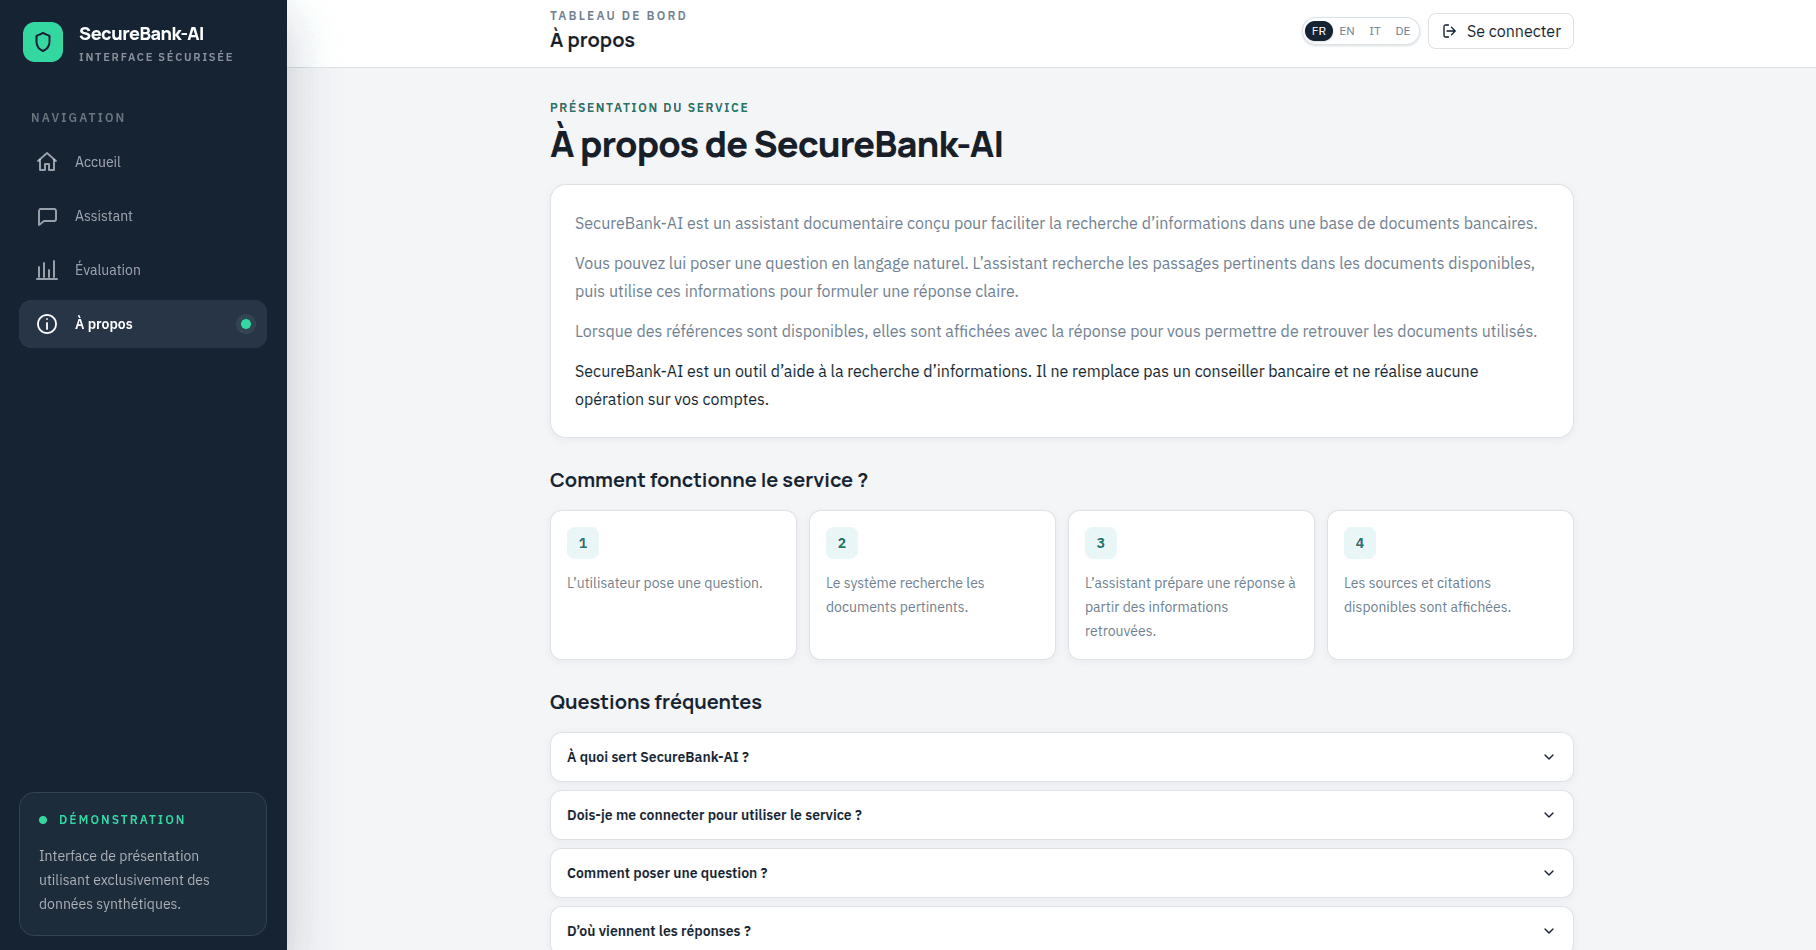
Le framework d’évaluation s’inscrit dans une application web complète, avec des frontières explicites entre services de retrieval, interface produit, déploiement et contrôles qualité.
Backend
- Python
- FastAPI
- API REST
- SQLite
Frontend
- React
- TypeScript
- Vite
- Dashboard analytique
- Interface multilingue
- Gestion des erreurs et des états de chargement
Déploiement
- Docker
- Backend sur Render
- Frontend sur Vercel
- Configuration par environnement
- Routage API et configuration du proxy
Qualité
- Pytest
- Vitest
- ESLint
- Ruff
- Tests automatisés et de régression
Dashboard du benchmark
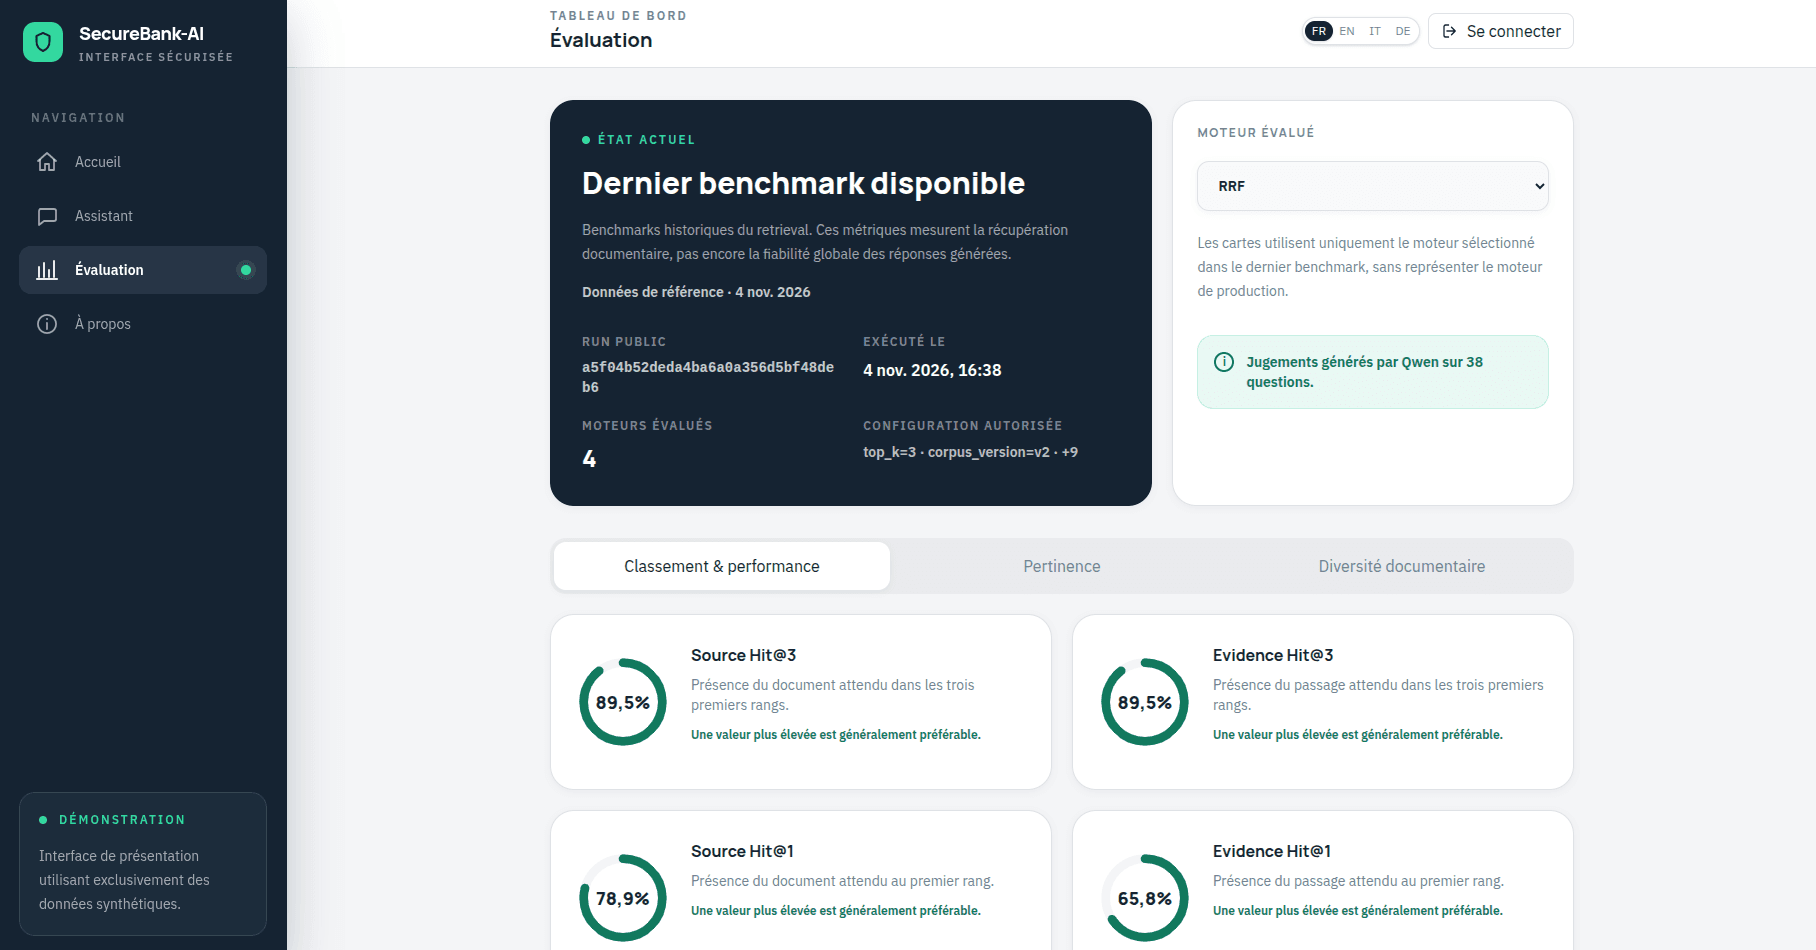
Le dashboard rend l’évaluation du retrieval inspectable au lieu de la masquer derrière une interface conversationnelle.
Des snapshots de référence maintiennent la vue analytique disponible lorsque le backend ne l’est pas. Ce sont des artefacts de résilience, pas des mesures en direct.
- Comparaison de quatre moteurs
- 22 indicateurs d’évaluation
- Historique des exécutions
- Provenance de l’évaluation
- Gestion des valeurs manquantes
- Snapshots de référence
Méthodologie et limites
- Le benchmark utilise des documents synthétiques.
- Les jugements de pertinence produits par Qwen ne sont pas équivalents à une revue humaine systématique.
- Les résultats décrivent ce benchmark expérimental, pas des performances bancaires réelles en production.
- L’application n’est pas un système bancaire réglementé et ne revendique aucune conformité.
- Le projet utilise des modèles préentraînés. Il n’entraîne pas de modèle de fondation depuis zéro.
- La disponibilité des fonctions RAG dans un déploiement public dépend de la configuration du backend.
Prochaines expérimentations possibles
Il s’agit de pistes futures, pas de fonctions déjà implémentées.
- RAG agentique
- Appels d’outils contrôlés
- Évaluation des réponses générées
- Observabilité IA
- Benchmarking automatisé
- Amélioration du déploiement des composants RAG
Concevoir → Expérimenter → Mesurer → Comparer → Améliorer
SecureBank-AI transforme les choix de retrieval en décisions d’ingénierie testables. Le benchmark ne certifie pas un produit bancaire ; il produit les éléments nécessaires pour choisir, questionner et améliorer une configuration RAG.