02 · AI Engineering / Valutazione del retrieval
SecureBank-AI — Proteggere una piattaforma RAG con RBAC e JWT
Una piattaforma RAG ibrida che integra autenticazione JWT e controllo degli accessi RBAC con il confronto riproducibile di quattro strategie di ricerca documentale: BM25, ricerca vettoriale, fusione RRF e reranking.
- Documenti sintetici
- 30
- Domande di valutazione
- 40
- Chunk indicizzati
- 172
Domanda ingegneristica
Come progettare e valutare un sistema RAG pertinente, integrandolo in un’applicazione affidabile con accessi controllati?
Sicurezza applicativa
Sicurezza applicativa e controllo degli accessi
SecureBank-AI non si limita a confrontare motori di ricerca documentale. Il progetto integra anche un livello di sicurezza applicativa per gestire l’identità degli utenti, controllare l’accesso alle funzionalità e proteggere le informazioni di autenticazione.
Questa dimensione completa il lavoro di AI Engineering: un sistema RAG deve inserirsi in un’applicazione strutturata, con API RAG protette, sessioni controllate e una gestione esplicita delle autorizzazioni.
- 01
Autenticazione & autorizzazione
JWT · RBAC · API RAG protette
La validazione JWT verifica firma, scadenza, emittente e audience prima di identificare l’utente. Dipendenze FastAPI esplicite autorizzano poi l’accesso alle risorse RAG in base al ruolo: l’autenticazione stabilisce l’identità, l’autorizzazione determina l’azione consentita. L’account demo configurato tramite ambiente usa il ruolo analyst.
- 02
Credenziali & sessioni
bcrypt · Cookie HttpOnly · CSRF
Le password sono sottoposte a hashing con bcrypt. I token di sessione e CSRF sono generati separatamente; i token di sessione sono memorizzati come hash in SQLite, scadono e vengono invalidati al logout. Il cookie di sessione è HttpOnly; SESSION_COOKIE_SECURE e SESSION_COOKIE_SAMESITE ne configurano la politica di trasporto. Il frontend invia i cookie con credentials: "include" e trasmette il token CSRF per le richieste mutabili.
- 03
Protezione delle API & configurazione
Origini attendibili · Variabili d’ambiente · Segreti
L’origine dei login è verificata rispetto a una lista consentita e le richieste mutabili autenticate tramite cookie richiedono la validazione CSRF. I tentativi di accesso falliti sono limitati. AUTH_TRUSTED_ORIGINS, JWT_SECRET_KEY e DEMO_USER_PASSWORD mantengono la configurazione sensibile fuori dall’interfaccia pubblica; qui non viene esposto alcun valore segreto.
- 04
Gestione utenti & persistenza
SQLite · User repository · Associazione dei ruoli
SQLiteUserRepository conserva account, hash delle password, stato di attivazione e associazione del ruolo. All’avvio, un account demo opzionale viene inizializzato in modo idempotente dalla configurazione d’ambiente con il ruolo analyst, senza sostituire un account esistente.
- Richiesta utenteIdentità e credenziali
- AutenticazioneValidazione JWT o sessione tramite cookie
- AutorizzazioneRBAC e dipendenza dal ruolo
- Risorse protetteAPI RAG e PII
PersistenzaSQLiteUtenti · Ruoli · Sessioni con hash
Configurazione runtimeAmbienteOrigini consentite · Politica dei cookie · Segreti
AI Engineering
RAG ibrido, strategie di retrieval, benchmarking e valutazione della rilevanza.
Software Engineering
FastAPI, React, TypeScript, API REST, persistenza, test e deployment.
Application Security
Autenticazione JWT, RBAC, hashing delle password, gestione delle sessioni e controllo degli accessi.
SecureBank-AI unisce la sperimentazione RAG a un’architettura full-stack che integra meccanismi di autenticazione, autorizzazione e gestione degli utenti.
La risposta si decide a monte
Un modello linguistico può fondare la risposta solo sul contesto ricevuto. Se il retrieval non trova il passaggio pertinente, assegna priorità a evidenze deboli o restituisce fonti ridondanti, la generazione parte con un deficit informativo.
SecureBank-AI tratta il retrieval come un sottosistema ingegneristico osservabile. Quattro motori alternativi seguono lo stesso protocollo sperimentale per confrontare il comportamento lessicale, semantico, ibrido e con reranking, invece di presumerlo.
Architettura di retrieval
I documenti vengono suddivisi in chunk, indicizzati per la ricerca lessicale e vettoriale, quindi interrogati tramite una delle quattro configurazioni di valutazione. RRF fonde le classifiche; FlashRank è uno stadio opzionale solo per la quarta configurazione.
Domanda
Chunk indicizzati
Configurazioni alternative
Contesto recuperatoIntegrazione LLM a valle
- 01
BM25
Una baseline lessicale che valuta i passaggi in base alla rilevanza dei termini.
- 02
Qdrant
Ricerca vettoriale semantica con embedding paraphrase-multilingual-MiniLM-L12-v2.
- 03
RRF
Reciprocal Rank Fusion combina le classifiche indipendenti di BM25 e Qdrant.
- 04
RRF + FlashRank
FlashRank riordina i candidati ibridi in una configurazione sperimentale distinta.
Metodologia di valutazione
RAG v2: un corpus, quattro configurazioni
Il benchmark usa 30 documenti sintetici, 40 domande e 172 chunk indicizzati. Qwen valuta 260 coppie domanda-documento per costruire annotazioni sperimentali di rilevanza; 38 domande su 40 hanno almeno un documento giudicato rilevante.
Lo stesso benchmark misura qualità del ranking, successo del retrieval, copertura di fonti ed evidenze, diversità, latenza ed errori per i quattro motori. I risultati sono osservazioni descrittive per questo corpus e questa configurazione.
I giudizi di rilevanza generati da un LLM sono annotazioni sperimentali, non una validazione umana sistematica.
- RAG v2
- 30 documenti
- 40 domande
- 172 chunk
- 4 strategie
- 260 coppie valutate
- 38/40 con evidenza rilevante
Risultati
RRF è la configurazione complessivamente più solida in questo benchmark
RRF guida le metriche osservate di ranking e retrieval mantenendo una latenza media vicina a 15 ms. È un risultato del benchmark, non un punteggio aggregato artificiale né una garanzia di produzione.
Risultato principaleRRF
Success@3 89,5%
- Precision@1
- 65,8%
- Recall@3
- 69,8%
- MAP@3
- 61,1%
- MRR@3
- 76,3%
- nDCG@3
- 64,3%
- Latenza media
- 15,0 ms
| Metrica | BM25 | Qdrant | RRF | RRF + FlashRank |
|---|---|---|---|---|
| Precision@1 | 52,6% | 63,2% | 65,8% — Miglior valore osservato | 52,6% |
| Recall@3 | 58,9% | 63,0% | 69,8% — Miglior valore osservato | 60,6% |
| MAP@3 | 50,5% | 56,4% | 61,1% — Miglior valore osservato | 50,9% |
| MRR@3 | 64,9% | 72,4% | 76,3% — Miglior valore osservato | 66,7% |
| nDCG@3 | 56,4% | 56,1% | 64,3% — Miglior valore osservato | 55,0% |
| Success@3 | 78,9% | 81,6% | 89,5% — Miglior valore osservato | 84,2% |
| Source Hit@3 | 89,5% — Miglior valore osservato | 86,8% | 89,5% — Miglior valore osservato | 89,5% — Miglior valore osservato |
| Evidence Hit@3 | 78,9% | 81,6% | 89,5% — Miglior valore osservato | 84,2% |
| Latenza media | 0,4 ms — Miglior valore osservato | 14,0 ms | 15,0 ms | 421,6 ms |
| Latenza P95 | 0,7 ms — Miglior valore osservato | 18,3 ms | 17,2 ms | 541,9 ms |
Mostra tutti i 22 indicatori
| Metrica | BM25 | Qdrant | RRF | RRF + FlashRank |
|---|---|---|---|---|
| Precision@1 | 52,6% | 63,2% | 65,8% — Miglior valore osservato | 52,6% |
| Precision@3 | 42,1% | 46,5% | 50,0% — Miglior valore osservato | 42,1% |
| Recall@1 | 27,3% | 30,8% | 31,2% — Miglior valore osservato | 26,8% |
| Recall@3 | 58,9% | 63,0% | 69,8% — Miglior valore osservato | 60,6% |
| F1@1 | 34,2% | 39,9% | 40,7% — Miglior valore osservato | 33,6% |
| F1@3 | 46,9% | 51,3% | 55,4% — Miglior valore osservato | 46,8% |
| MAP@3 | 50,5% | 56,4% | 61,1% — Miglior valore osservato | 50,9% |
| Success@1 | 52,6% | 63,2% | 65,8% — Miglior valore osservato | 52,6% |
| Success@3 | 78,9% | 81,6% | 89,5% — Miglior valore osservato | 84,2% |
| Source Hit@1 | 71,1% | 71,1% | 78,9% — Miglior valore osservato | 63,2% |
| Source Hit@3 | 89,5% — Miglior valore osservato | 86,8% | 89,5% — Miglior valore osservato | 89,5% — Miglior valore osservato |
| Evidence Hit@1 | 52,6% | 63,2% | 65,8% — Miglior valore osservato | 52,6% |
| Evidence Hit@3 | 78,9% | 81,6% | 89,5% — Miglior valore osservato | 84,2% |
| MRR@3 | 64,9% | 72,4% | 76,3% — Miglior valore osservato | 66,7% |
| nDCG@3 | 56,4% | 56,1% | 64,3% — Miglior valore osservato | 55,0% |
| Latenza media | 0,4 ms — Miglior valore osservato | 14,0 ms | 15,0 ms | 421,6 ms |
| Latenza P50 | 0,4 ms — Miglior valore osservato | 13,0 ms | 15,6 ms | 422,7 ms |
| Latenza P95 | 0,7 ms — Miglior valore osservato | 18,3 ms | 17,2 ms | 541,9 ms |
| Tasso di errore | 0% — Miglior valore osservato | 0% — Miglior valore osservato | 0% — Miglior valore osservato | 0% — Miglior valore osservato |
| Chunk restituiti in media | 3 | 3 | 3 | 3 |
| Documenti distinti@3 | 2,37 | 2,29 | 2,21 | 2,45 — Miglior valore osservato |
| Diversità delle fonti@3 | 78,9% | 76,3% | 73,7% | 81,6% — Miglior valore osservato |
Compromessi ingegneristici
Il reranking non è automaticamente vantaggioso
Rispetto a RRF, FlashRank riduce MAP@3 dal 61,1% al 50,9%, nDCG@3 dal 64,3% al 55,0% e Success@3 dall’89,5% all’84,2%. La latenza media sale da 15,0 ms a 421,6 ms — circa 28×. Il compromesso osservato è specifico del corpus, del benchmark e della configurazione.
BM25 resta una baseline utile
BM25 raggiunge l’89,5% di Source Hit@3 con una latenza media di 0,4 ms. Il retrieval lessicale resta un’opzione credibile a bassa latenza; la ricerca vettoriale non è intrinsecamente superiore.
L’ibrido RRF dimostra il proprio valore
MAP@3 passa dal 50,5% di BM25 e dal 56,4% di Qdrant al 61,1% di RRF. L’osservazione sostiene la valutazione di approcci lessicali, semantici e ibridi invece di scegliere un motore per presupposti.
Implementazione full-stack
Il framework di valutazione fa parte di un’applicazione web completa, con confini espliciti tra servizi di retrieval, interfaccia prodotto, deployment e controlli di qualità.
Backend
- Python
- FastAPI
- API REST
- SQLite
Frontend
- React
- TypeScript
- Vite
- Dashboard analitica
- Interfaccia multilingue
- Gestione di errori e stati di caricamento
Deployment
- Docker
- Backend su Render
- Frontend su Vercel
- Configurazione per ambiente
- Routing API e configurazione proxy
Qualità
- Pytest
- Vitest
- ESLint
- Ruff
- Test automatici e di regressione
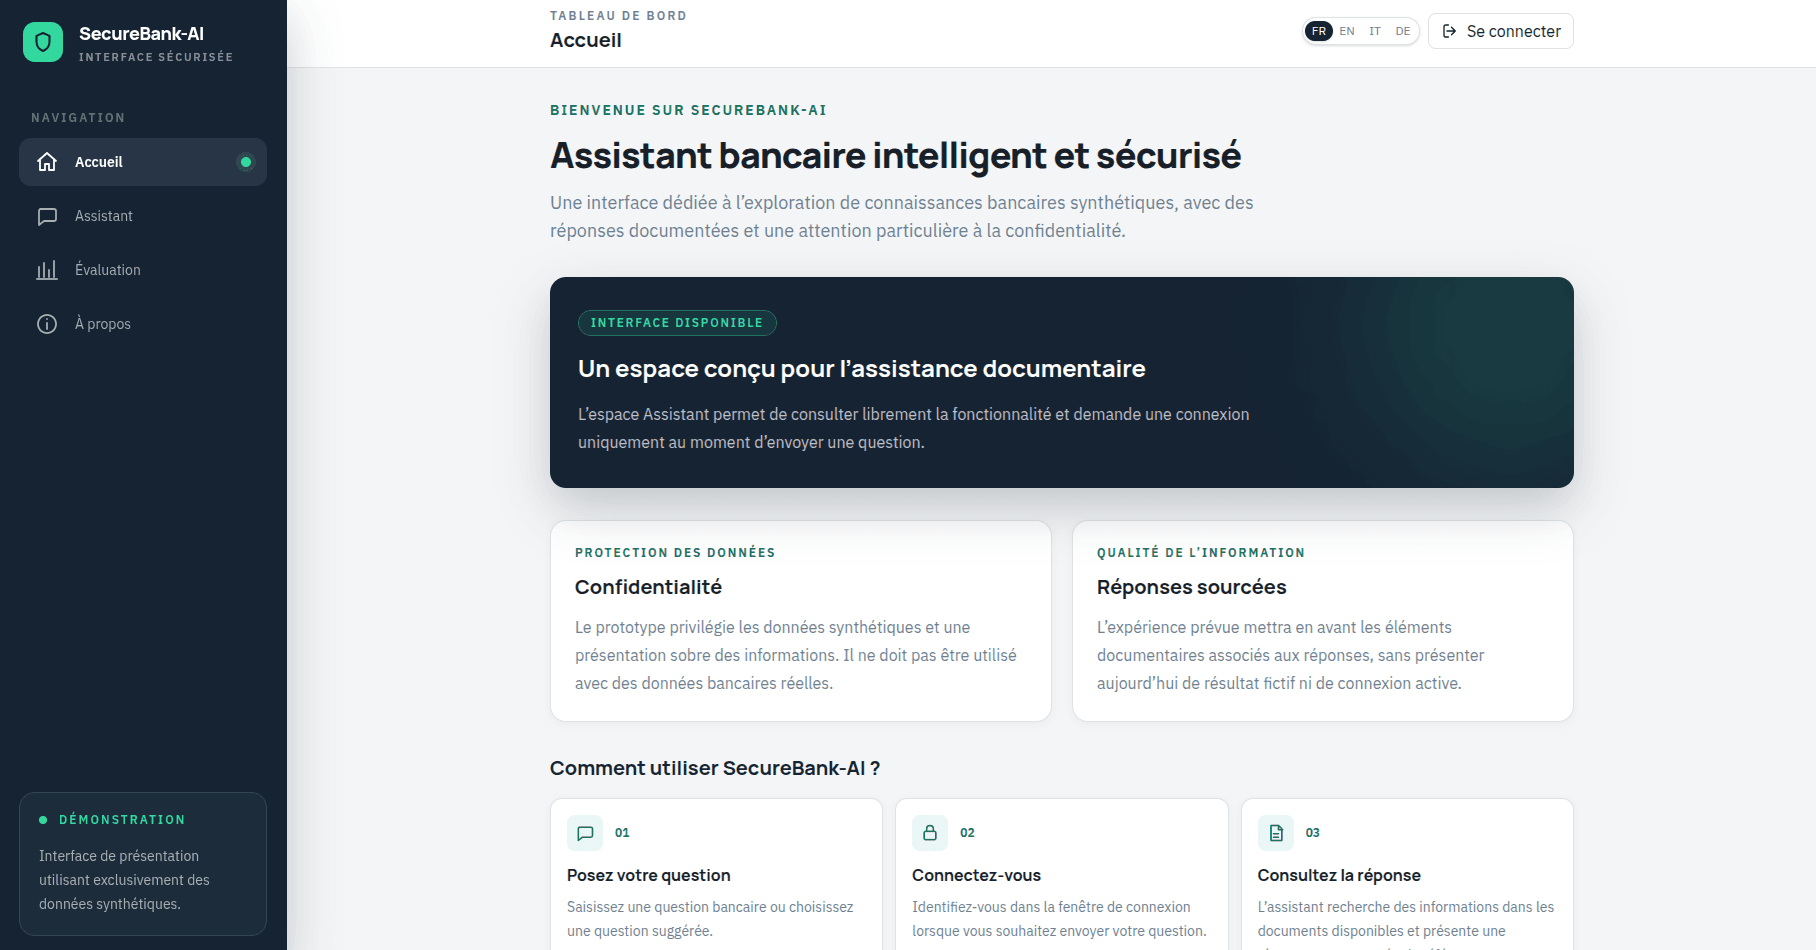
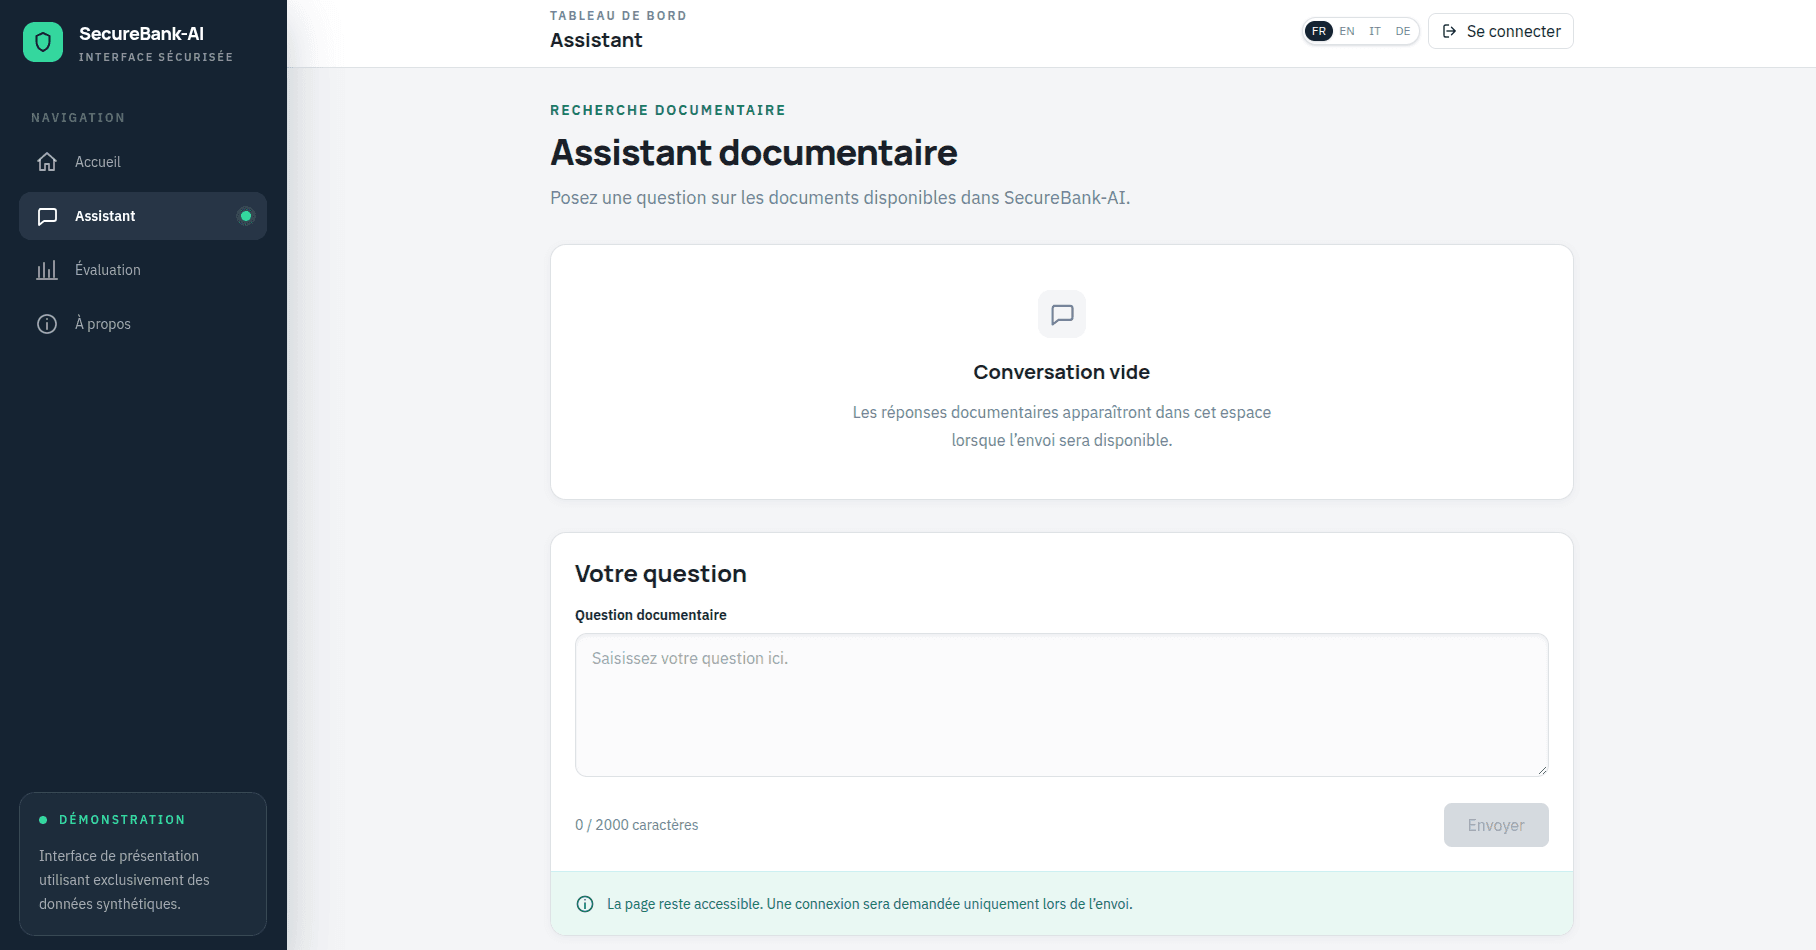
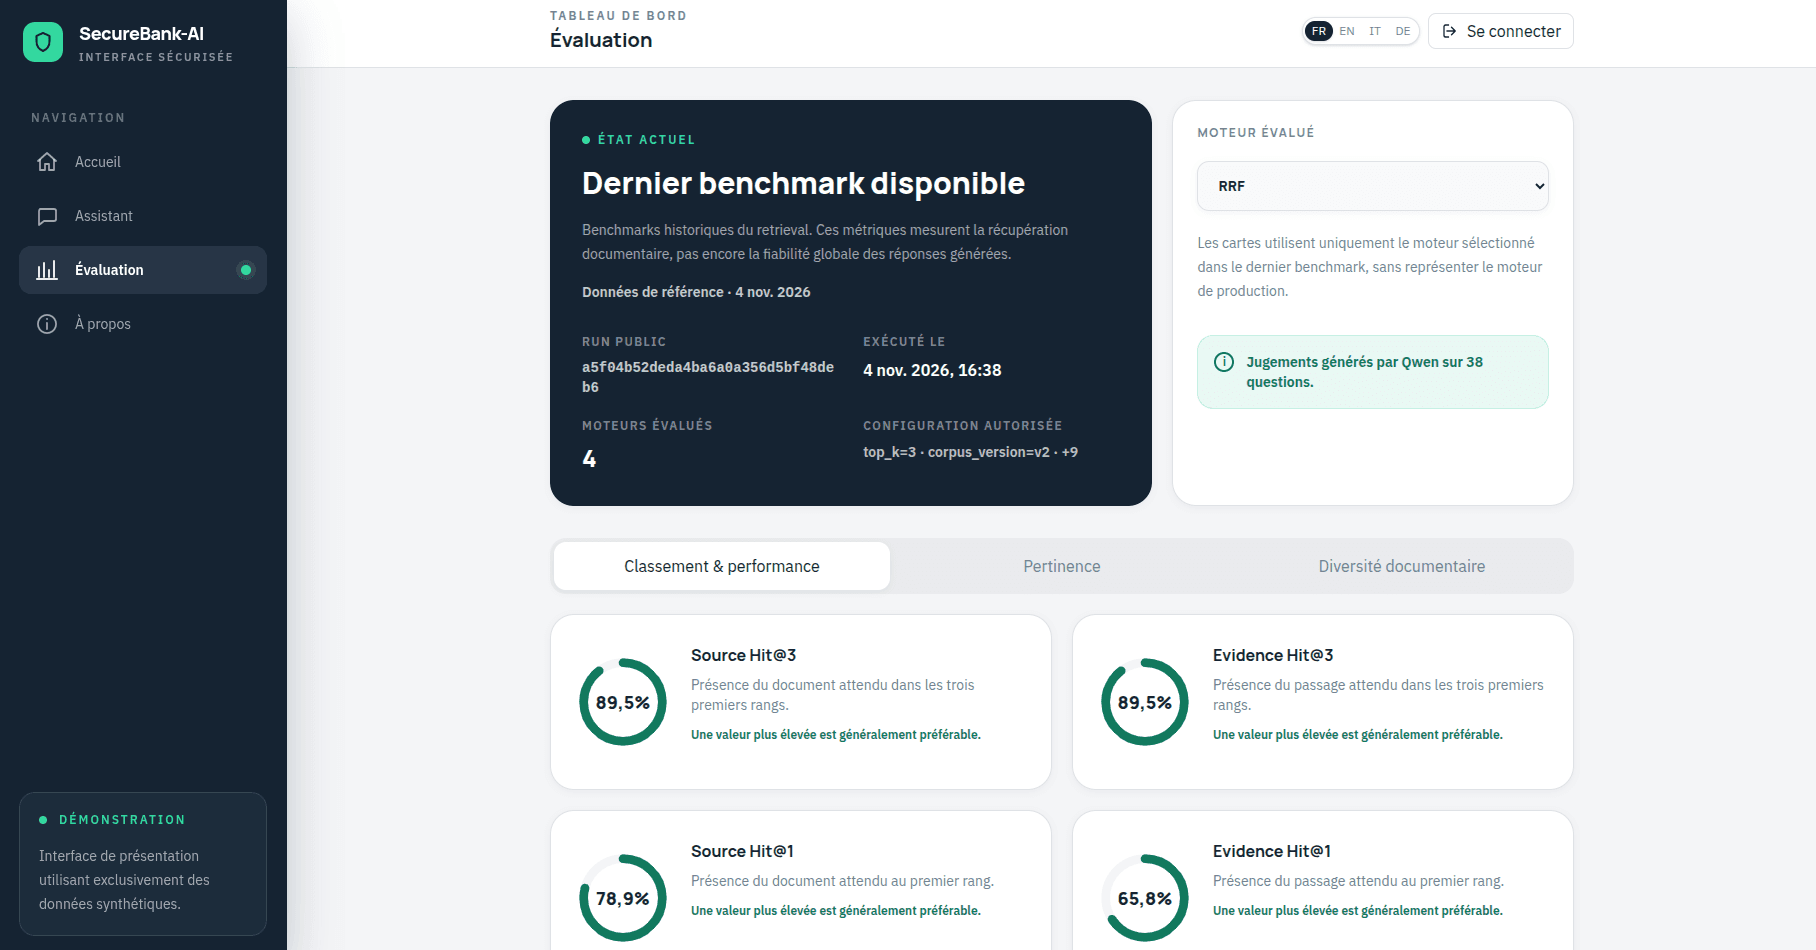
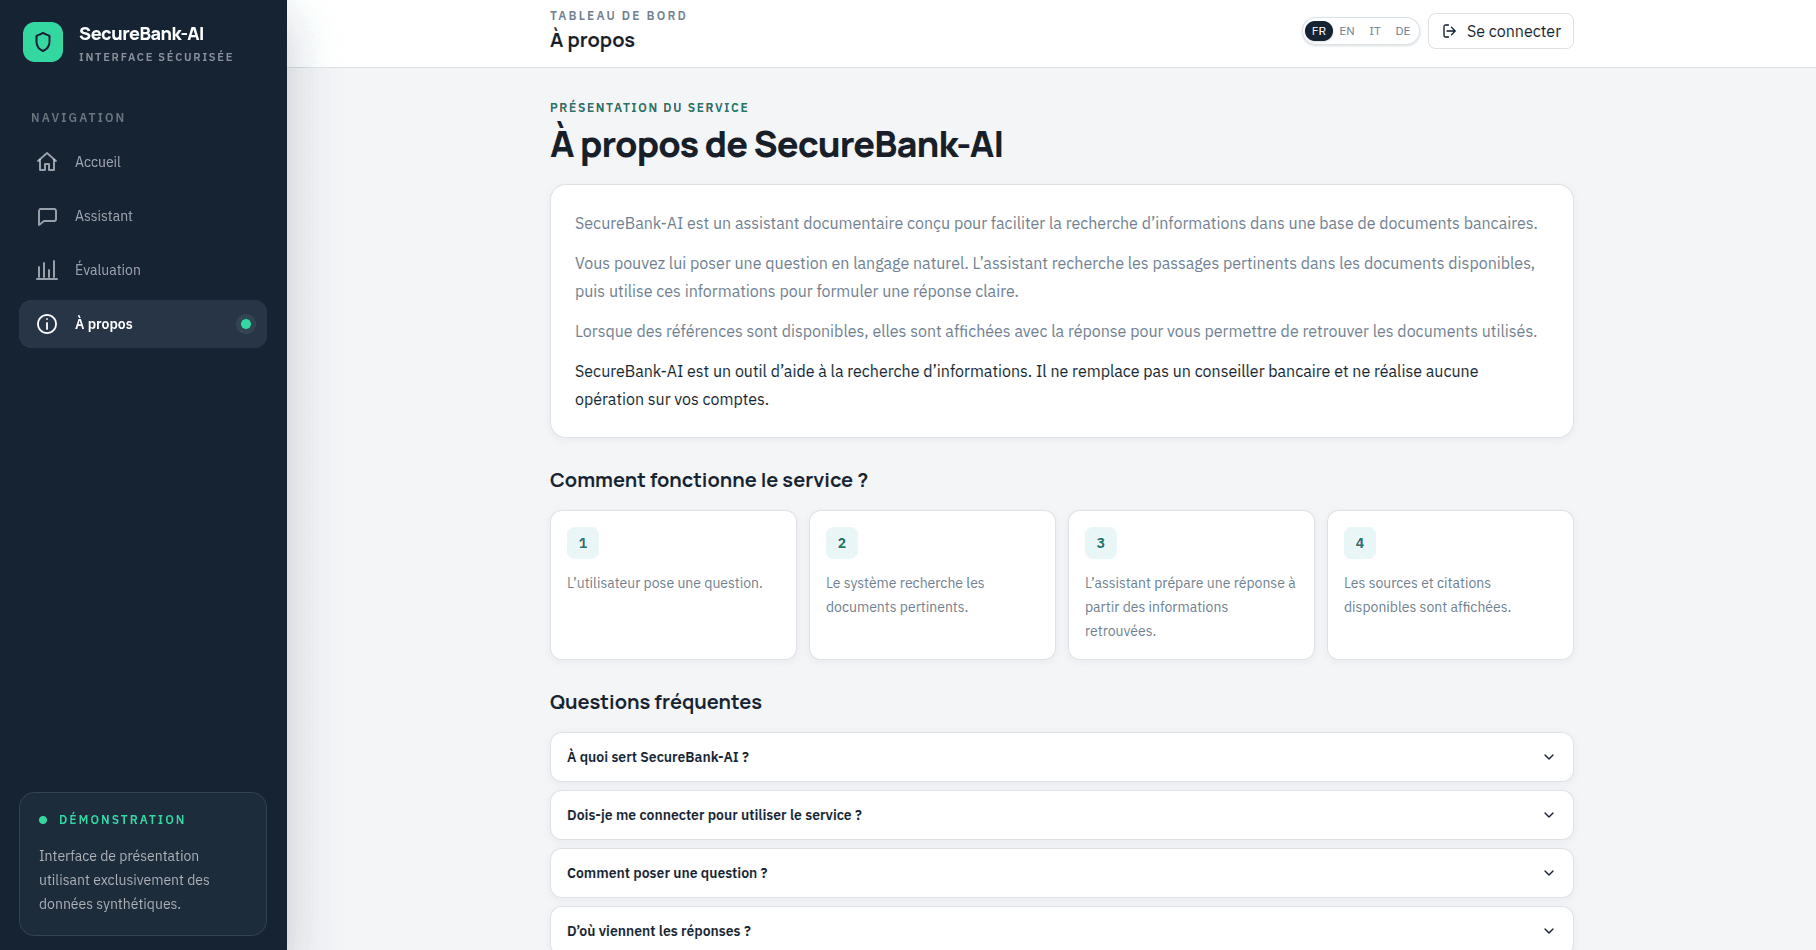
Dashboard del benchmark
La dashboard rende ispezionabile la valutazione del retrieval invece di nasconderla dietro un’interfaccia conversazionale.
Gli snapshot di riferimento mantengono disponibile la vista analitica quando il backend non lo è. Sono artefatti di resilienza, non misurazioni in tempo reale.
- Confronto fra quattro motori
- 22 indicatori di valutazione
- Storico delle esecuzioni
- Provenienza della valutazione
- Gestione dei valori mancanti
- Snapshot di riferimento
Metodologia e limiti
- Il benchmark usa documenti sintetici.
- I giudizi di rilevanza prodotti da Qwen non equivalgono a una revisione umana sistematica.
- I risultati descrivono questo benchmark sperimentale, non prestazioni bancarie reali in produzione.
- L’applicazione non è un sistema bancario regolamentato e non rivendica conformità.
- Il progetto usa modelli preaddestrati; non addestra un foundation model da zero.
- La disponibilità delle funzionalità RAG in un deployment pubblico dipende dalla configurazione del backend.
Possibili esperimenti futuri
Sono direzioni future, non funzionalità già implementate.
- RAG agentico
- Tool calling controllato
- Valutazione delle risposte generate
- Osservabilità AI
- Benchmarking automatico
- Migliore deployment dei componenti RAG
Progettare → Sperimentare → Misurare → Confrontare → Migliorare
SecureBank-AI trasforma le scelte di retrieval in decisioni ingegneristiche verificabili. Il benchmark non certifica un prodotto bancario; crea le evidenze necessarie per scegliere, mettere in discussione e migliorare una configurazione RAG.