01 · Ingénierie RAG / Étude comparative

Du prototype assisté par IA au RAG évalué

Un exercice d’ingénierie comparatif sur ce que le développement assisté par IA apporte à un produit RAG fonctionnel, et sur la discipline supplémentaire nécessaire pour évaluer et améliorer sa fiabilité.

Temps de développement
~10 h baseline / ~20 h engineered
Corpus de référence
7 payslips / 5 technical PDFs
Benchmark figé
36 INFOPAY cases / 72 AEROSPEC cases

La question

Jusqu’où le développement assisté par IA permet-il de construire un prototype RAG fonctionnel, et quel travail d’ingénierie faut-il pour déterminer si ce RAG est réellement fiable ?

Baseline · ~10 h

Prototype 01 — INFOPAY-AI

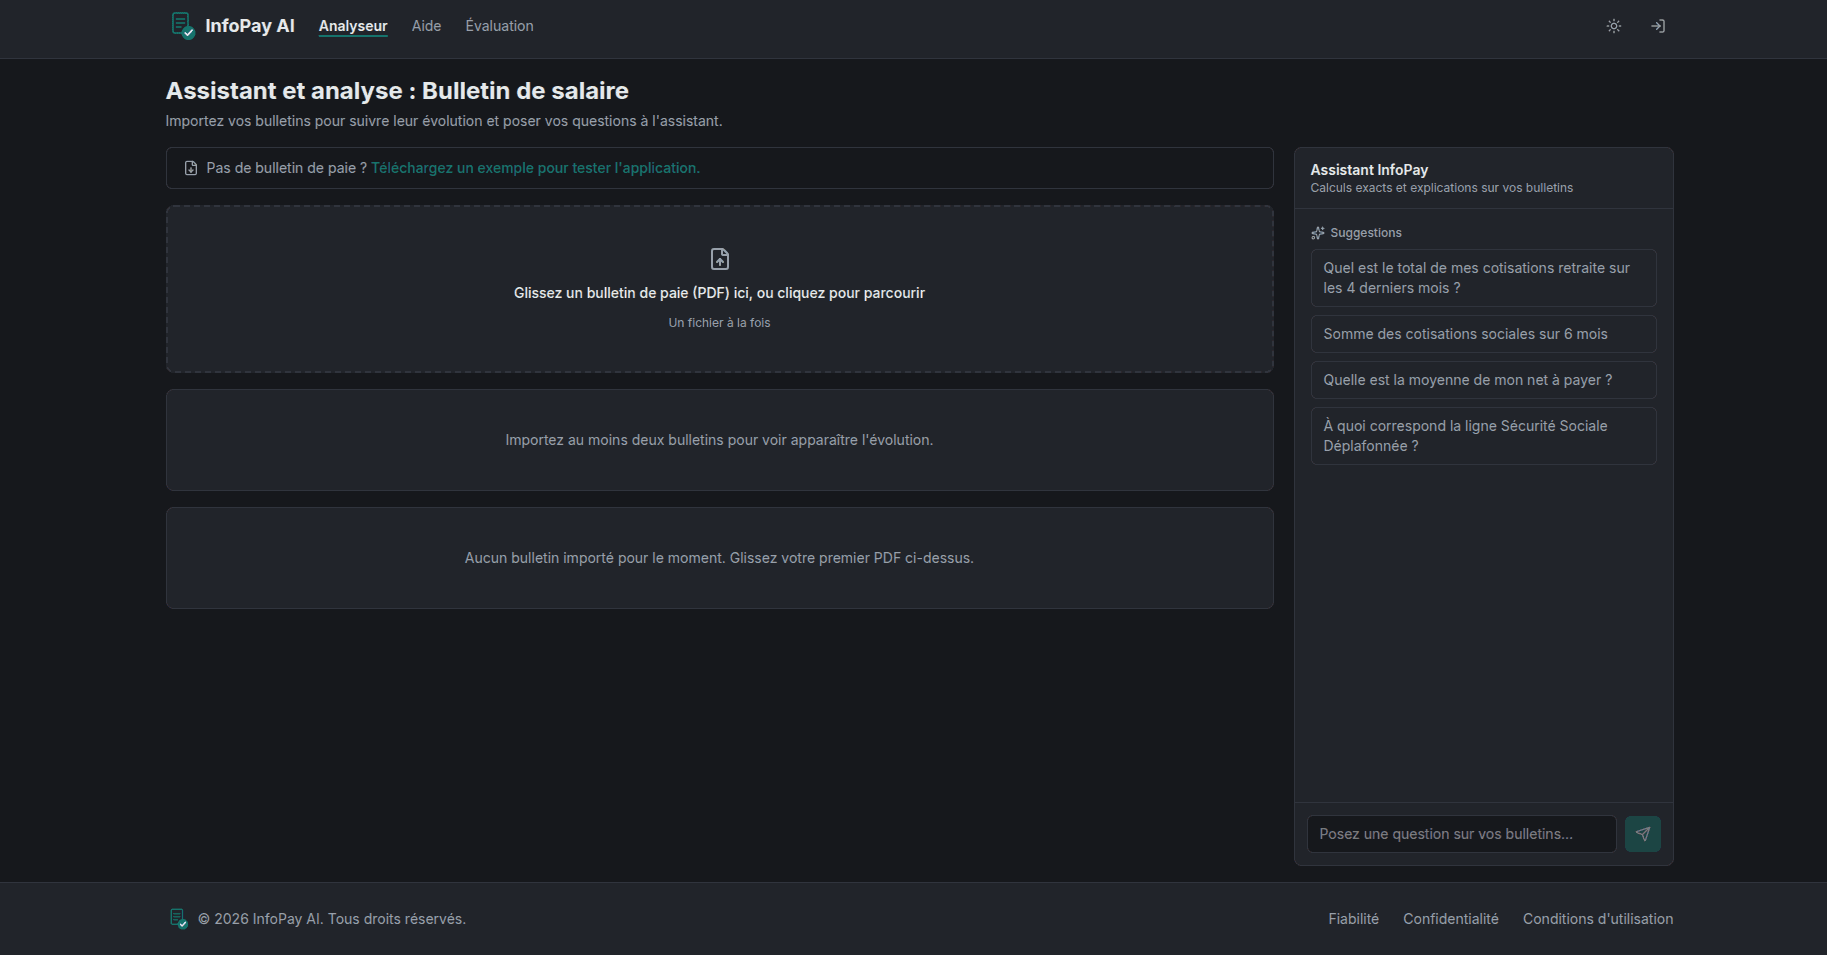
INFOPAY-AI interface

Développé en environ 10 heures, INFOPAY-AI constitue la base rapide assistée par IA. Claude Code a contribué à produire un produit fonctionnel qui importe des bulletins de paie PDF de formats variés, extrait les données structurées, visualise plusieurs mois et répond en langage naturel.

Son architecture hybride confie les opérations numériques faisant autorité à Pandas. Les questions documentaires utilisent un RAG avec ChromaDB, tandis que LangChain et LangGraph assurent l’orchestration. L’interaction reste naturelle sans déléguer les calculs de référence au modèle.

Le prototype peut sembler satisfaisant en usage courant, mais des réponses plausibles et un fonctionnement apparent ne prouvent pas la fiabilité de la recherche. Les métriques INFOPAY sont encore attendues.

Voir le projet: INFOPAY-AI
Configuration du benchmark INFOPAY
  • all-MiniLM-L6-v2
  • ONNXMiniLM_L6_V2
  • claude-sonnet-4-6
  • langchain_anthropic
  • top_k = 3
  • distance threshold = 1.1
  • chunk_size = 800
  • overlap = 100
  • 7 PDFs
  • 7 documents
  • 13 chunks

Pour quatre questions de culture générale entièrement hors sujet, INFOPAY reçoit explicitement l’instruction de répondre depuis les connaissances générales du modèle sans rechercher les bulletins. Le taux d’abstention de 0 % pour cette catégorie est intentionnel et n’est pas classé comme un échec de recherche.

Engineered · ~20 h

Prototype 02 — AEROSPEC-AI

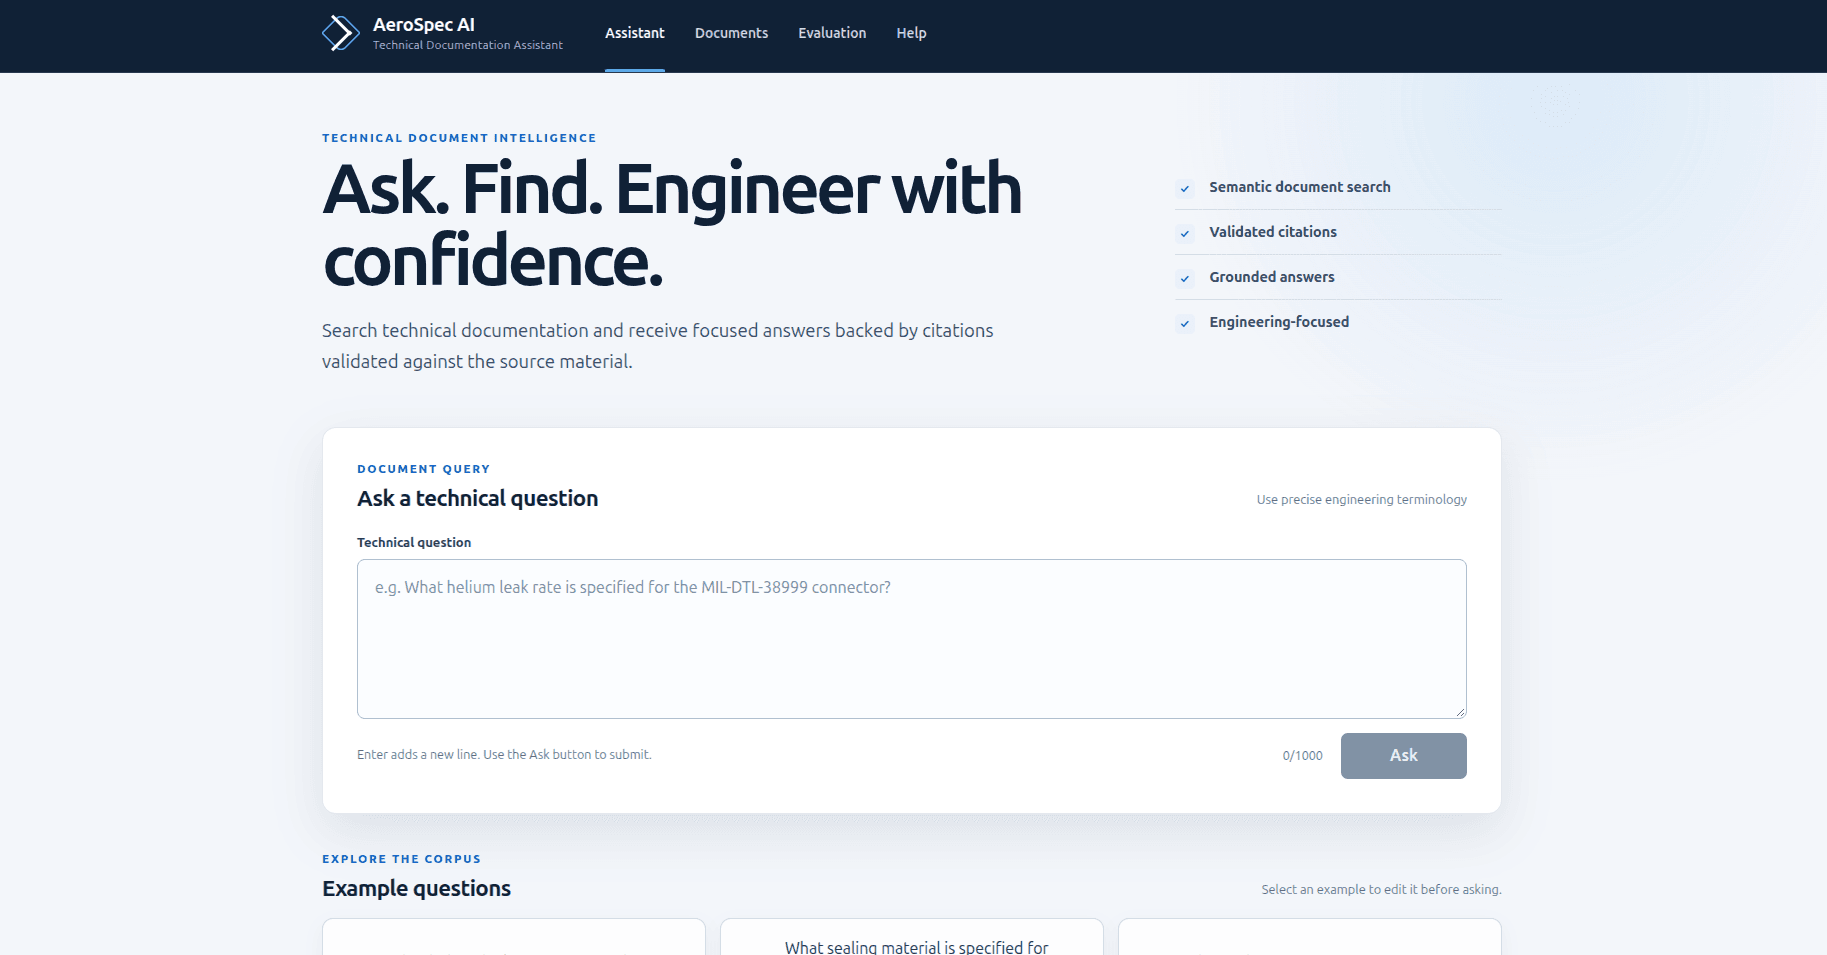
AEROSPEC-AI interface

Développé en environ 20 heures, AEROSPEC-AI travaille sur de la documentation technique et privilégie la qualité mesurable de la recherche, la reproductibilité, la traçabilité des sources, les citations, l’abstention et l’analyse des erreurs.

Ses frontières explicites séparent React/Vite, FastAPI, la recherche Chroma, la génération OpenAI, la validation des citations et l’interface JSON. /search inspecte la recherche sans génération /ask ajoute génération et citations ; les opérations déterministes /convert n’utilisent pas de LLM.

Pydantic valide les contrats, les identifiants de requête et les logs structurés facilitent le diagnostic, et les contenus sensibles des questions, prompts, chunks et réponses sont exclus des logs. Les identifiants de citation sont validés avant le retour de la provenance.

Voir le projet: AEROSPEC-AI

Architecture de référence

Les frontières recherche, génération, validation, API et interface restent explicites.

  1. React / Vite
  2. FastAPI
  3. Chroma retrieval
  4. OpenAI generation
  5. Citation validation
  6. JSON response
  7. Interface

/search retrieval inspection

/ask retrieval + generation + citations

/convert deterministic operations

Ce qui change

Prototype rapide assisté par IAÉtude d’ingénierie contrôlée
Comportement apparentComportement mesuré
RAG fonctionnelBenchmark de recherche explicite
Génération de réponseRéponse et stratégie d’abstention
Sources disponiblesProvenance des citations validée
Impression manuelleÉvaluation reproductible

Méthodologie d’évaluation

Deux benchmarks, deux résultats descriptifs.

INFOPAY-AI a été évalué le 24 septembre 2026 sur 36 questions : 24 répondables, 12 sans réponse et 7 bulletins de paie fictifs. AEROSPEC-AI a été évalué le 22 septembre 2026 sur 72 questions : 48 répondables, 24 sans réponse et 5 documents PDF techniques.

Source Hit vérifie si le document attendu est retrouvé. Evidence Hit pose une question plus stricte : le chunk contient-il la preuve complète nécessaire ? L’abstention mesure le refus de répondre, et les contrôles de citation valident une provenance traçable.

Les deux prototypes ont été évalués sur des benchmarks distincts. Les écarts ci-dessous décrivent leurs résultats respectifs et illustrent l’évolution de la démarche d’ingénierie ; ils ne constituent pas une expérience A/B sur un corpus identique. Les benchmarks diffèrent par leur taille, leur domaine et leurs documents sources, et aucun ne mesure une performance globale en production.

Résultats automatiques de référence

INFOPAY-AI
Source Hit@333.3%
+56.3 ptsAmélioration
AEROSPEC-AI
Source Hit@389.6%

La bonne source ne garantit pas la preuve complète

INFOPAY obtient 33,3 % en Source Hit@3 et 20,8 % en Evidence Hit@3 ; AEROSPEC obtient 89,6 % et 54,2 % sur son propre benchmark. Identifier la bonne source ne garantit pas la récupération de la preuve nécessaire. AEROSPEC améliore les deux mesures sur son benchmark, mais l’écart restant montre que la précision de recherche doit encore progresser.

L’abstention reste un compromis

Le système s’abstient correctement sur de nombreux cas sans réponse, mais les fausses abstentions restent importantes. C’est un axe d’investigation, pas un comportement résolu.

MétriqueINFOPAY-AIAEROSPEC-AIÉvolution
Source Hit@125.0%87.5% +62.5 pts (Amélioration)
Source Hit@333.3%89.6% +56.3 pts (Amélioration)
Evidence Hit@112.5%35.4% +22.9 pts (Amélioration)
Evidence Hit@320.8%54.2% +33.4 pts (Amélioration)
Abstentions correctes66.7%83.3% +16.6 pts (Amélioration)
Fausses abstentions54.2%39.6% -14.6 pts (Amélioration)

Traçabilité

Non directement comparable

INFOPAY-AI

Les sources sont reconstruites mécaniquement depuis les ToolMessages LangGraph sous forme de métadonnées mois/extrait. Cinq cas répondables sur 24 ont produit au moins une source et 9/9 enregistrements extraits contenaient des champs non vides. Cela ne vérifie pas le support sémantique d’une affirmation générée.

Replies + source
5 / 24 · 20.8%
Well-formed sources
9 / 9 · 100%

AEROSPEC-AI

AEROSPEC a émis 37/37 identifiants de citation valides, tous résolus vers leur provenance, sans identifiant inconnu. Cela valide la structure et la provenance des citations, pas le support sémantique.

Valid IDs
37 / 37
Resolved
37 / 37
Unknown IDs
0 / 37

Évaluation humaine

La correction des réponses, le grounding, la couverture et le support sont non applicables pour les deux benchmarks actuels, car aucune revue humaine cas par cas n’a été réalisée. Ces valeurs ne sont pas enregistrées à zéro.

Analyse des erreurs

  1. 01La bonne source est retrouvée, mais la preuve complète manque.
  2. 02Une réponse est produite malgré des preuves insuffisantes dans le top 3.
  3. 03Le système ne s’abstient pas sur un cas sans réponse.

Itération contrôlée

Le benchmark reste fixe et une seule variable change à la fois. Ces expériences sont prévues ; aucune amélioration n’est encore affirmée.

  1. 01top_k : 3 → 5
  2. 02Si nécessaire, chunk_size : 1000 → 600
  3. 03Ensuite seulement, modifier le prompt de génération

Stack technique

Conclusion

Un système RAG qui fonctionne en démonstration n’est pas nécessairement fiable.

Cette base montre pourquoi l’évaluation de la recherche, la mesure au niveau des preuves, l’analyse de l’abstention, la traçabilité et l’expérimentation reproductible comptent. AEROSPEC-AI n’est pas présenté comme totalement fiable : son benchmark rend visibles ses faiblesses restantes.