01 · Ingegneria RAG / Studio comparativo

Dal prototipo assistito dall’IA al RAG valutato

Un esercizio ingegneristico comparativo su ciò che lo sviluppo assistito dall’IA offre a un prodotto RAG funzionale e sulla disciplina aggiuntiva necessaria per valutarne e migliorarne l’affidabilità.

Tempo di sviluppo
~10 h baseline / ~20 h engineered
Corpus di riferimento
7 payslips / 5 technical PDFs
Benchmark fisso
36 INFOPAY cases / 72 AEROSPEC cases

La domanda

Fino a che punto lo sviluppo assistito dall’IA può portare un prototipo RAG funzionale, e quale lavoro ingegneristico serve per stabilire se il RAG è davvero affidabile?

Baseline · ~10 h

Prototipo 01 — INFOPAY-AI

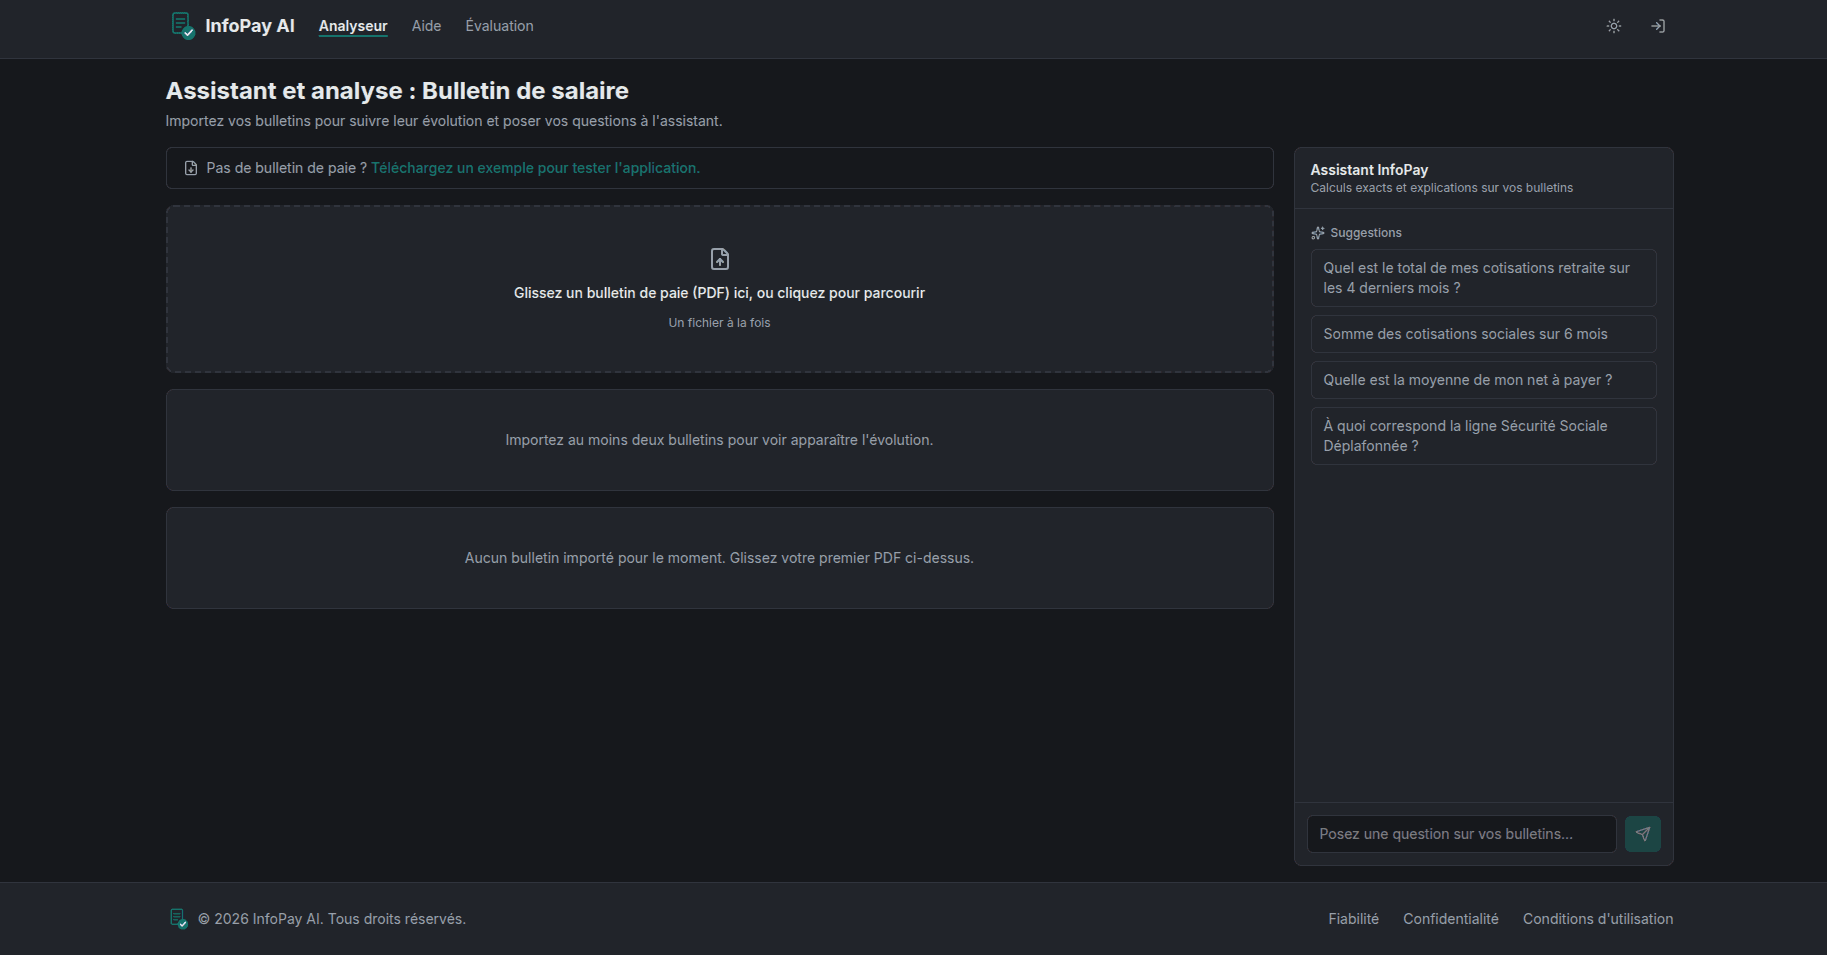
INFOPAY-AI interface

Realizzato in circa 10 ore, INFOPAY-AI è la baseline rapida assistita dall’IA. Claude Code ha contribuito a produrre un’applicazione funzionale che importa cedolini PDF con layout diversi, estrae dati strutturati, visualizza più mesi e risponde in linguaggio naturale.

L’architettura ibrida affida a Pandas le operazioni numeriche autorevoli. Le domande sui documenti usano RAG con ChromaDB, mentre LangChain e LangGraph gestiscono l’orchestrazione. L’interazione resta naturale senza delegare al modello i calcoli autorevoli.

Il prototipo può sembrare soddisfacente nell’uso ordinario, ma risposte plausibili e funzionalità apparente non dimostrano l’affidabilità del retrieval. Le metriche INFOPAY sono ancora in attesa.

Vedi il progetto: INFOPAY-AI
Configurazione del benchmark INFOPAY
  • all-MiniLM-L6-v2
  • ONNXMiniLM_L6_V2
  • claude-sonnet-4-6
  • langchain_anthropic
  • top_k = 3
  • distance threshold = 1.1
  • chunk_size = 800
  • overlap = 100
  • 7 PDFs
  • 7 documents
  • 13 chunks

Per quattro domande di cultura generale completamente fuori tema, INFOPAY riceve esplicitamente l’istruzione di rispondere dalla conoscenza generale del modello senza cercare nei cedolini. Il tasso di astensione dello 0% in questa categoria è intenzionale e non è classificato come errore di retrieval.

Engineered · ~20 h

Prototipo 02 — AEROSPEC-AI

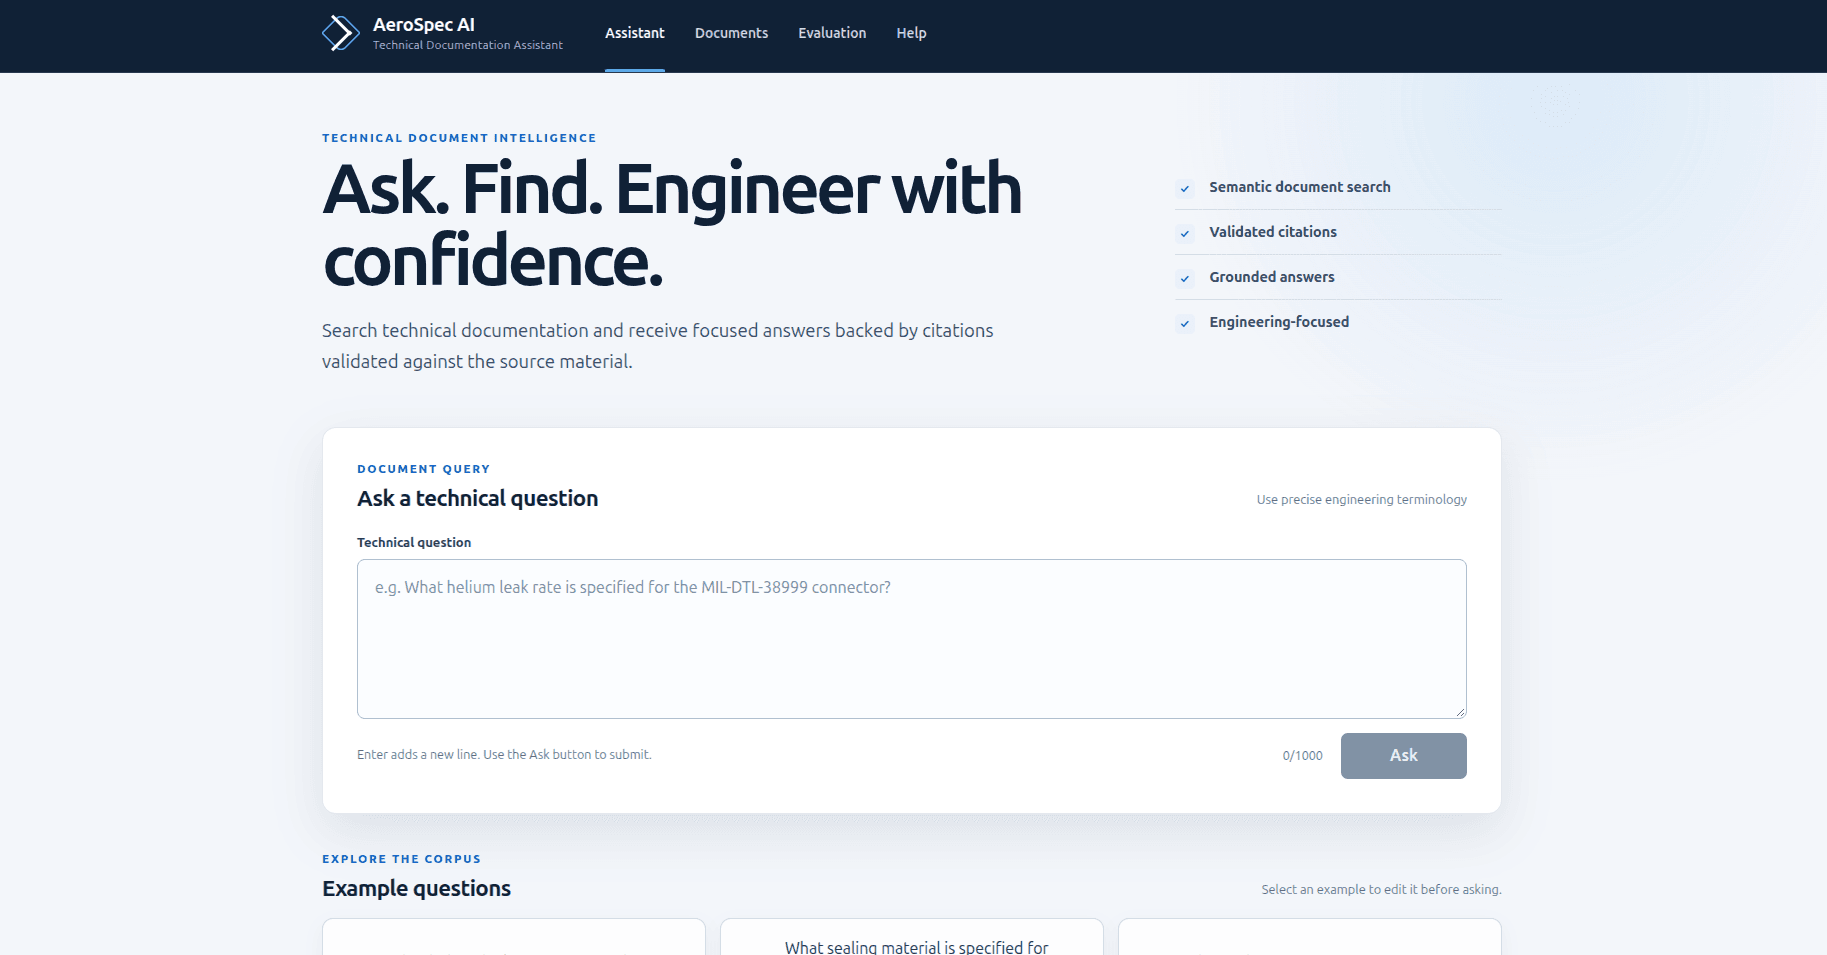
AEROSPEC-AI interface

Realizzato in circa 20 ore, AEROSPEC-AI lavora con documentazione tecnica e si concentra su qualità misurabile del retrieval, riproducibilità, tracciabilità delle fonti, citazioni, astensione e analisi degli errori.

I confini espliciti separano React/Vite, FastAPI, retrieval Chroma, generazione OpenAI, validazione delle citazioni e interfaccia JSON. /search ispeziona il retrieval senza generazione; /ask aggiunge generazione e citazioni; le operazioni deterministiche /convert non richiedono un LLM.

Pydantic valida i contratti, request ID e log strutturati supportano la diagnostica, mentre contenuti sensibili di domande, prompt, chunk e risposte sono esclusi dai log. Gli identificatori delle citazioni sono validati prima di restituire la provenienza.

Vedi il progetto: AEROSPEC-AI

Architettura di riferimento

I confini tra retrieval, generazione, validazione, API e interfaccia restano espliciti.

  1. React / Vite
  2. FastAPI
  3. Chroma retrieval
  4. OpenAI generation
  5. Citation validation
  6. JSON response
  7. Interface

/search retrieval inspection

/ask retrieval + generation + citations

/convert deterministic operations

Cosa cambia

Prototipo rapido assistito dall’IAStudio ingegneristico controllato
Comportamento apparenteComportamento misurato
RAG funzionaleBenchmark esplicito del retrieval
Generazione della rispostaRisposta e strategia di astensione
Fonti disponibiliProvenienza delle citazioni validata
Impressione manualeValutazione riproducibile

Metodologia di valutazione

Due benchmark, due risultati descrittivi.

INFOPAY-AI è stato valutato il 24 settembre 2026 su 36 domande: 24 rispondibili, 12 senza risposta e 7 cedolini fittizi. AEROSPEC-AI è stato valutato il 22 settembre 2026 su 72 domande: 48 rispondibili, 24 senza risposta e 5 documenti PDF tecnici.

Source Hit verifica se è stato recuperato il documento previsto. Evidence Hit pone una domanda più rigorosa: il chunk contiene tutte le prove necessarie? L’astensione misura quando il sistema non risponde, mentre i controlli sulle citazioni validano una provenienza tracciabile.

I due prototipi sono stati valutati su benchmark distinti. Le differenze seguenti descrivono i rispettivi risultati e illustrano l’evoluzione dell’approccio ingegneristico; non costituiscono un esperimento A/B sullo stesso corpus. I benchmark differiscono per dimensioni, dominio e documenti sorgente, e nessuno dei due misura prestazioni generali in produzione.

Risultati automatici di baseline

INFOPAY-AI
Source Hit@333.3%
+56.3 ptsMigliorato
AEROSPEC-AI
Source Hit@389.6%

La fonte corretta non garantisce evidenze complete

INFOPAY ottiene 33,3% per Source Hit@3 e 20,8% per Evidence Hit@3; AEROSPEC ottiene 89,6% e 54,2% sul proprio benchmark. Identificare la fonte corretta non garantisce il recupero delle evidenze necessarie. AEROSPEC migliora entrambe le misure sul suo benchmark, ma il divario residuo indica che la precisione del retrieval deve ancora migliorare.

L’astensione resta un compromesso

Il sistema si astiene correttamente in molti casi senza risposta, ma le false astensioni restano significative. È un’area da indagare, non un problema risolto.

MetricaINFOPAY-AIAEROSPEC-AIEvoluzione
Source Hit@125.0%87.5% +62.5 pts (Migliorato)
Source Hit@333.3%89.6% +56.3 pts (Migliorato)
Evidence Hit@112.5%35.4% +22.9 pts (Migliorato)
Evidence Hit@320.8%54.2% +33.4 pts (Migliorato)
Astensioni corrette66.7%83.3% +16.6 pts (Migliorato)
False astensioni54.2%39.6% -14.6 pts (Migliorato)

Tracciabilità

Non direttamente comparabile

INFOPAY-AI

Le fonti sono ricostruite meccanicamente dai ToolMessages LangGraph come metadati mese/estratto. Cinque casi rispondibili su 24 hanno prodotto almeno una fonte e 9/9 record estratti avevano campi non vuoti. Ciò non verifica il supporto semantico di una specifica affermazione generata.

Replies + source
5 / 24 · 20.8%
Well-formed sources
9 / 9 · 100%

AEROSPEC-AI

AEROSPEC ha emesso 37/37 ID di citazione validi, tutti risolti alla provenienza, senza ID sconosciuti. Ciò valida struttura e provenienza delle citazioni, non il supporto semantico.

Valid IDs
37 / 37
Resolved
37 / 37
Unknown IDs
0 / 37

Valutazione umana

Correttezza delle risposte, grounding, copertura e supporto non sono applicabili agli attuali benchmark perché non è stata eseguita una revisione umana caso per caso. Questi valori non sono registrati come zero.

Analisi degli errori

  1. 01La fonte corretta viene recuperata, ma mancano evidenze complete.
  2. 02Viene prodotta una risposta nonostante evidenze insufficienti nei primi tre risultati.
  3. 03Il sistema non si astiene su un caso senza risposta.

Iterazione controllata

Il benchmark resta fisso e cambia una sola variabile alla volta. Sono esperimenti pianificati; non si afferma ancora alcun miglioramento.

  1. 01top_k: 3 → 5
  2. 02Se necessario, chunk_size: 1000 → 600
  3. 03Solo dopo, modificare il prompt di generazione

Stack tecnico

Conclusione

Un sistema RAG che funziona in una demo non è necessariamente affidabile.

La baseline mostra perché valutazione del retrieval, misurazione delle evidenze, analisi dell’astensione, tracciabilità e sperimentazione riproducibile sono essenziali. AEROSPEC-AI non è presentato come pienamente affidabile: il benchmark rende visibili le debolezze rimanenti.